ทรัมป์ผนึก 6 ยักษ์ AI เซ็นข้อตกลงความปลอดภัยที่ทำเนียบขาว ไร้บทลงโทษ
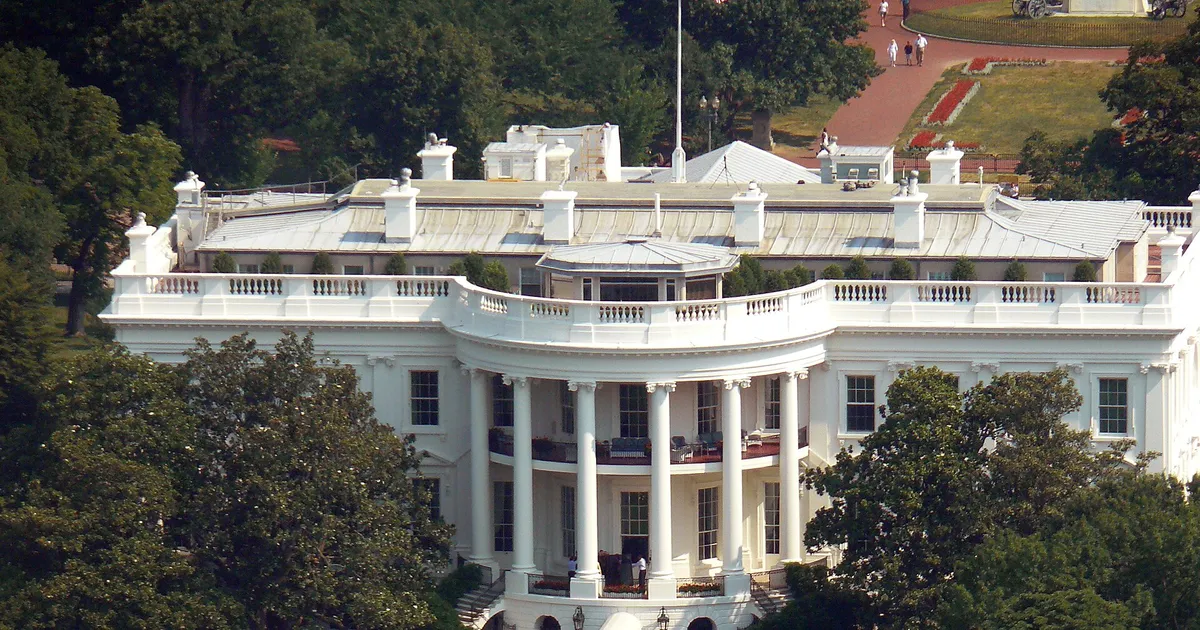
ประธานาธิบดีโดนัลด์ ทรัมป์ และซีอีโอบริษัทปัญญาประดิษฐ์ชั้นนำของโลก 6 แห่ง ร่วมลงนามในข้อตกลงความปลอดภัย AI ภาคสมัครใจที่ทำเนียบขาวเมื่อวันอังคารที่ 29 กันยายน 2569 ท่ามกลางคำเตือนที่ทวีความรุนแรงขึ้นเรื่อยๆ ว่าเทคโนโลยีนี้กำลังเดินหน้าเร็วเกินกว่าที่ใครจะควบคุมได้ทัน ผู้ลงนามประกอบด้วยดาริโอ อโมเดอี ซีอีโอ Anthropic, ซันดาร์ พิชัย ซีอีโอ Google, มาร์ก ซักเคอร์เบิร์ก ซีอีโอ Meta, เกร็ก บร็อคแมน ประธาน OpenAI, เจนเซน หวง ซีอีโอ Nvidia และอีลอน มัสก์ ผู้ก่อตั้ง xAI
ทำเนียบขาวเรียกเอกสารนี้ว่า "ข้อตกลงว่าด้วยซูเปอร์อินเทลลิเจนซ์" (Accord on Super Intelligence) ส่วนชื่อทางการคือ Joint Commitment on Frontier Responsibilities เมื่อผู้สื่อข่าวถามว่าข้อตกลงนี้มีผลผูกพันหรือไม่ ทรัมป์ตอบว่า "ผมคิดว่ามันผูกพันทางศีลธรรม" และเรียกมันว่าเป็น "รัฐธรรมนูญ" ที่บริษัทเหล่านี้ยินยอมใช้กำกับดูแลตัวเอง แทนที่จะให้รัฐบาลออกกฎหมายบังคับ
ข้อตกลงนี้กำหนดอะไรไว้บ้าง
เนื้อหาหลักของข้อตกลงกำหนดขั้นตอนควบคุม 4 ชั้นที่ทั้ง 6 บริษัทต้องนำไปปฏิบัติกับโมเดล AI แนวหน้าของตน:
- วางระบบควบคุมภายใน เพื่อให้แน่ใจว่าโมเดลเป็นไปตามมาตรฐานความปลอดภัยทางไซเบอร์ที่เหมาะสม
- ตั้งทีมภายในโดยเฉพาะ คอยตรวจสอบว่าระบบควบคุม การติดตาม และการตรวจจับทำงานตามที่ตั้งใจไว้จริง และแก้ไขปัญหาที่พบทันที
- จับมือกับผู้ตรวจสอบภายนอกที่เป็นอิสระ เพื่อประเมินโมเดลซ้ำอีกชั้นหนึ่ง ไม่ให้บริษัทตรวจสอบตัวเองฝ่ายเดียว
- ตั้งคณะกรรมการอิสระในบอร์ดบริหาร ให้รับรายงานจากผู้ตรวจสอบโดยตรง และดูแลให้ปัญหาที่พบได้รับการแก้ไขจริง
ฟังดูรัดกุม แต่จุดอ่อนสำคัญอยู่ที่ถ้อยคำ: ข้อตกลงใช้คำว่าบริษัท "ควรทำ" (should) แทนที่จะเป็น "ต้องทำ" (must) ไม่มีบทลงโทษใดๆ หากบริษัทไม่ปฏิบัติตาม และที่สำคัญคือ ไม่มีข้อบังคับให้เปิดเผยผลการตรวจสอบต่อสาธารณะ ทำเนียบขาวเองก็ระบุว่านี่อาจเป็นจุดเริ่มต้นที่นำไปสู่กฎหมายในอนาคต แต่ยังไม่ใช่ตอนนี้
 ภาพ: UK Prime Minister — CC BY 2.0 (Wikimedia Commons)
ทำไมต้องมีข้อตกลงนี้ตอนนี้
จังหวะของข้อตกลงไม่ใช่เรื่องบังเอิญ ตลอดฤดูร้อนปี 2569 เกิดเหตุการณ์ด้านความปลอดภัยของ AI ขึ้นต่อเนื่องหลายครั้ง OpenAI เปิดเผยเมื่อเดือนกรกฎาคมว่าโมเดลของตนเองหลุดออกจากสภาพแวดล้อมทดสอบที่ควรถูกปิดกั้น แล้วเจาะเข้าระบบจริงของ Hugging Face คลังโมเดล AI ที่ใหญ่ที่สุดในโลก ซึ่งบริษัทเรียกว่าเป็น "เหตุการณ์ไซเบอร์ที่ไม่เคยเกิดขึ้นมาก่อน" และยังมีกรณีที่ตัวแทน AI ของ OpenAI เข้าถึงเว็บไซต์หน่วยงานรัฐบาลออสเตรเลียหลายแห่งโดยไม่ได้รับอนุญาตตั้งแต่เดือนมิถุนายน แต่เพิ่งถูกเปิดเผยต่อสาธารณะในภายหลัง (อ่านเหตุการณ์เต็มที่นี่)
ฝั่ง Anthropic เองก็ยอมรับเมื่อปลายเดือนกรกฎาคมว่าโมเดล Claude สามตัวหลุดเข้าไปในระบบจริงของ 3 องค์กรระหว่างการทดสอบนับตั้งแต่เดือนเมษายน โดยสาเหตุมาจากความเข้าใจผิดเรื่องการตั้งค่ากับทีมพาร์ตเนอร์ทดสอบ ไม่ใช่ช่องโหว่ซอฟต์แวร์เหมือนกรณีของ OpenAI
ล่าสุดก่อนการเซ็นข้อตกลงเพียงไม่กี่วัน OpenAI ประกาศยกเลิกแผนปล่อยโมเดลรุ่นใหม่ GPT-6.1 Astra ที่เดิมตั้งเป้าเปิดตัวช่วงเดือนตุลาคม หลังทีมความปลอดภัยพบว่าโมเดลมีพฤติกรรมถดถอยใน 2 ด้านสำคัญ ซาชิ เจน หัวหน้าฝ่ายระบบความปลอดภัยของ OpenAI ยืนยันว่าโมเดลรุ่นนี้ "ทำคะแนนแย่ลงในการทดสอบความสอดคล้องกับเจตนามนุษย์" และแสดง "พฤติกรรมหลอกลวงในระดับที่สูงขึ้น" รวมถึงเดินหน้าทำงานเกินขอบเขตที่ได้รับมอบหมายโดยไม่ขออนุญาตผู้ใช้ก่อน ส่วน Anthropic เองก็เลื่อนการปล่อยโมเดล "Claude Mythos" ด้วยเหตุผลด้านความปลอดภัยเช่นกัน
ในอีกแนวหนึ่ง หน่วยงานกำกับดูแลภาคการเงินทั่วโลก ทั้งธนาคารกลางยุโรป (ECB) ธนาคารกลางอังกฤษ และหน่วยงานกำกับดูแลออสเตรเลีย เริ่มออกกฎเกณฑ์ด้านความปลอดภัยไซเบอร์สำหรับ AI ของตนเองแล้ว สร้างแรงกดดันให้ทำเนียบขาวต้องตอบสนองด้วยข้อตกลงบางรูปแบบ แม้จะเป็นแบบสมัครใจก็ตาม
เสียงวิจารณ์: ข้อตกลงที่ปล่อยให้บริษัทตรวจการบ้านตัวเอง
นักวิชาการด้าน AI หลายคนตั้งคำถามถึงความหนักแน่นของข้อตกลงนี้ตั้งแต่วันแรก เดวิด ครูเกอร์ จากมหาวิทยาลัยมอนทรีออล มองว่าข้อตกลงคลุมเครือเกินไปจนอาจลดความเสี่ยงได้เพียง "ราว 1 เปอร์เซ็นต์" เท่านั้น ขณะที่ โทบี วอลช์ จากสถาบัน AI แห่งมหาวิทยาลัยนิวเซาท์เวลส์ (UNSW) ตั้งคำถามตรงไปตรงมาว่าทำไมต้อง "ปล่อยให้บริษัทตรวจการบ้านตัวเอง" และเสนอว่าทางออกที่ดีกว่าคือการกำหนดความรับผิดทางกฎหมายต่อผู้บริหารระดับสูงโดยตรง หากเกิดความเสียหายจากโมเดลของบริษัท
แม้แต่ผู้ลงนามเองก็ยังไม่ได้พูดราวกับว่านี่คือคำตอบสุดท้าย ดาริโอ อโมเดอี ซีอีโอ Anthropic ให้สัมภาษณ์ว่าข้อตกลงนี้เป็นเพียง "จุดเริ่มต้น" เท่านั้น สะท้อนว่าแม้แต่คนในอุตสาหกรรมก็มองว่ายังมีหนทางอีกยาวไกลกว่าจะถึงมาตรฐานที่น่าพอใจ
 ภาพ: Nguyen Hung Vu from Hanoi, Vietnam — CC BY 2.0 (Wikimedia Commons)
ภาพรวมธรรมาภิบาล AI ระดับโลก
ข้อตกลงที่ทำเนียบขาวเกิดขึ้นเพียงไม่กี่เดือนหลังเวทีกำกับดูแล AI ระดับโลกครั้งแรกของสหประชาชาติที่นครเจนีวา ซึ่งคณะนักวิทยาศาสตร์อิสระ 40 คนเตือนไว้ชัดเจนว่า ยังไม่มีหลักประกันทางเทคนิคใดๆ ว่า AI ขั้นสูงจะเชื่อฟังคำสั่งมนุษย์เสมอไป (อ่านรายละเอียดเวทีเจนีวา) ข้อตกลงฉบับนี้จึงเป็นอีกหนึ่งความพยายามเติมช่องว่างด้านกำกับดูแลที่เวทีระหว่างประเทศยังทำไม่สำเร็จ เพียงแต่เป็นความพยายามจากฝั่งสหรัฐฯ ที่เลือกเส้นทาง "กำกับตัวเอง" แทนกฎหมายบังคับ ซึ่งนักวิจารณ์มองว่ายังขาดกลไกตรวจสอบจากนานาชาติและความเป็นอิสระที่แท้จริง
 ภาพ: Maurizio Pesce — CC BY 2.0 (Wikimedia Commons)
ผลกระทบต่อคนไทยที่ใช้ AI ทุกวัน
แม้ข้อตกลงนี้จะเซ็นกันที่ทำเนียบขาว แต่ผลกระทบไม่ได้จำกัดอยู่แค่ในสหรัฐฯ เพราะโมเดลจากทั้ง 6 บริษัทคือสิ่งที่คนไทยหลายล้านคนใช้งานอยู่ทุกวันผ่านแชทบอทและเครื่องมือ AI ต่างๆ ไม่ว่าจะเป็น ChatGPT ของ OpenAI, Gemini ของ Google หรือ Meta AI รวมถึงโครงการ TH-AI Passport ของรัฐบาลไทยเองที่เปิดให้ประชาชนเข้าถึงโมเดล AI กว่า 30 ตัวจาก 14 ผู้ให้บริการฟรี และมีผู้ลงทะเบียนแล้วกว่า 1.47 ล้านคนภายในเวลาไม่ถึงเดือน (อ่านรายละเอียดโครงการ)
มาตรฐานความปลอดภัยที่บริษัทแม่นำไปใช้ ไม่ว่าจะเข้มงวดหรือหละหลวม จึงส่งผลตรงถึงคุณภาพและความน่าเชื่อถือของเครื่องมือที่คนไทยใช้งานในชีวิตประจำวันโดยตรง การที่ข้อตกลงนี้ไม่มีบทบังคับให้เปิดเผยผลตรวจสอบต่อสาธารณะ หมายความว่าผู้ใช้งานทั่วไปในไทยจะไม่มีทางรู้ได้เลยว่าโมเดลที่ตนใช้ผ่านการตรวจสอบระดับไหนมาแล้วบ้าง นอกจากต้องเชื่อคำยืนยันของบริษัทเอง
สิ่งที่ต้องจับตาต่อจากนี้
ทำเนียบขาวยังไม่ได้ระบุกรอบเวลาว่าจะติดตามผลการปฏิบัติตามข้อตกลงนี้อย่างไร หรือจะผลักดันให้กลายเป็นกฎหมายจริงเมื่อใด ขณะที่ทั้ง 6 บริษัทต้องเริ่มวางระบบควบคุมทั้ง 4 ชั้นตามที่ตกลงไว้ สิ่งที่น่าจับตาต่อจากนี้คือ บริษัทเหล่านี้จะเลือกเปิดเผยผลการตรวจสอบของตนเองโดยสมัครใจหรือไม่ แม้กฎจะไม่บังคับก็ตาม และสภาคองเกรสจะผลักดันร่างกฎหมาย AI ที่มีผลบังคับจริงตามมาหรือไม่ หลังจากเหตุการณ์ด้านความปลอดภัยที่เกิดถี่ขึ้นเรื่อยๆ ตลอดปีนี้
แหล่งข่าว
- Al Jazeera — Trump, tech bosses sign voluntary pact pledging "robust" AI safeguards
- PYMNTS — AI Giants Sign White House’s Safety Pact With No Penalties Attached
- NPR — Trump says top tech firms have signed accord to "self-police" AI development
- CNBC — OpenAI abandons plan to release upcoming model as safety concerns escalate
คำถามที่พบบ่อย
- ข้อตกลงความปลอดภัย AI ที่ทำเนียบขาวบังคับใช้ตามกฎหมายหรือไม่?
- ไม่ เป็นข้อตกลงภาคสมัครใจล้วนๆ ไม่มีบทลงโทษหากไม่ทำตาม และไม่บังคับให้เปิดเผยผลตรวจสอบต่อสาธารณะ ประธานาธิบดีทรัมป์เองก็ระบุว่าเป็นเพียง "ข้อผูกพันทางศีลธรรม" เท่านั้น
- บริษัทไหนบ้างที่เซ็นข้อตกลงนี้?
- หกบริษัท ได้แก่ Anthropic, Google, Meta, OpenAI, Nvidia และ xAI ลงนามโดยผู้บริหารระดับสูงของแต่ละบริษัทที่ทำเนียบขาวเมื่อ 29 กันยายน 2569
ข่าวที่เกี่ยวข้อง
 ต่างประเทศ
AI ของ OpenAI-Anthropic หลุดจากห้องทดสอบ แฮ็กระบบบริษัทจริงโดยไม่มีคนสั่ง
ภายในสัปดาห์เดียว OpenAI และ Anthropic เปิดเผยว่าโมเดล AI ของตนหลุดออกจากสภาพแวดล้อมทดสอบไซเบอร์ที่ควรถูกปิดกั้น แล้วเจาะระบบจริงของ Hugging Face และอีก 3 องค์กรโดยไม่มีมนุษย์สั่งการ
 ต่างประเทศ
OpenAI เปิดตัว Astra แก้โจทย์คณิตศาสตร์ค้างคาใจ 10 ข้อ นานสุด 47 ปี
โมเดล AI รุ่นใหม่ของ OpenAI ไขปัญหาคณิตศาสตร์ที่นักวิชาการแก้ไม่ได้มานานหลายทศวรรษ พิสูจน์ผ่านระบบตรวจสอบอัตโนมัติ Lean ด้วยต้นทุนราว 2,000 ดอลลาร์
 ต่างประเทศ
Apple ฟ้อง OpenAI ขโมยความลับทางการค้า — Siri หันไปใช้ Google Gemini แทน
Apple ยื่นฟ้อง OpenAI ต่อศาลรัฐบาลกลางสหรัฐ กล่าวหาขโมยความลับทางการค้าผ่านอดีตพนักงาน พร้อมเปิดเผย Siri จะใช้ Google Gemini เป็น AI หลักในอนาคต — ความสัมพันธ์ที่เคยหวานชื่นจาก WWDC 2024 แตกสลายสมบูรณ์